2026年10月19日,第33届国际多媒体建模会议(MMM'27)论文录用结果公布。MMRC实验室在推荐系统方向的研究成果被录用。
论文名称:Diffusion-Driven Progressive Heterogeneous Feature Alignment
论文作者:胥硕(山东大学);孟雷*(山东大学);涂腾(新加坡国立大学);李爱(中国科学院大学);马浩凯(新加坡国立大学);马云山(新加坡管理大学);孟祥旭(山东大学)
Paper链接:
https://github.com/Shuo-Xu-0319/BundleLM/blob/main/MMM27_BundleLM_Bundle Construction_Using_Language_Model%20.pdf
Code链接:
https://github.com/Shuo-Xu-0319/BundleLM
论文简介:BundleLM是一种面向多媒体捆绑架构的自回归生成框架,旨在解决传统方法依赖固定长度补全、只能优化单个物品预测、难以判断捆绑是否完整的问题。模型首先融合物品的多模态内容特征、协同过滤特征与ID嵌入:对于时尚场景,利用图像与文本信息描述服饰属性;对于音乐场景,则整合音频与元数据信息,并通过 LightGCN 获取用户—物品交互关系。融合后的物品表示既保留语义相似性,也包含用户偏好和跨物品协同关系。在生成阶段,BundleLM将捆绑组合中的每个物品视为类似语言token 的生成单元,并使用带因果掩码的Transformer Decoder按顺序预测后续物品。尽管捆绑包本质上是无序集合,训练时会随机排列其中物品,并在序列末尾加入显式的结束标记,使模型能够同时学习“下一个应生成什么物品”以及“何时应该停止生成”。为减少过早停止和无止境生成,模型在标准next-item loss外设计了早停约束与晚停约束:前者抑制模型在bundle尚未完整时过早预测结束标记,后者促使模型在生成完整目标后及时终止。在监督微调完成后,BundleLM进一步采用 GRPO 进行强化学习对齐。模型针对同一输入前缀采样多个候选捆绑包,并基于组内相对奖励更新策略。奖励由三部分组成:语义相似度奖励衡量生成捆绑与真实捆绑的整体语义接近程度;Jaccard 奖励衡量物品集合重合度;长度对齐奖励约束生成结果的规模,避免过短或过长。通过“自回归生成+显式终止+多奖励强化学习”的联合设计,BundleLM能够生成兼具物品相关性、整体兼容性、长度合理性和语义完整性的捆绑包。
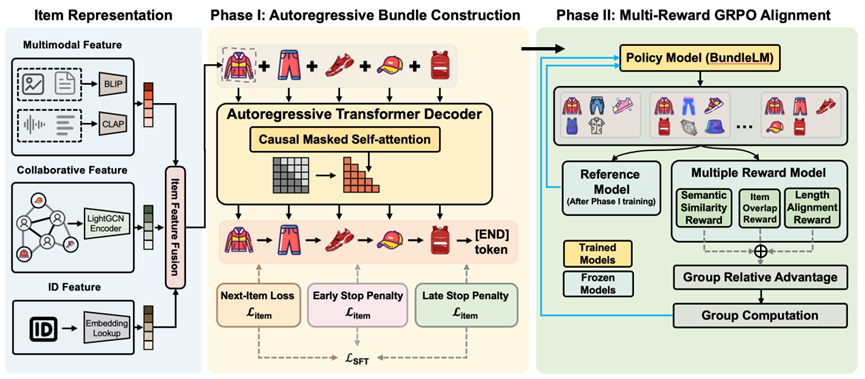
图1:BundleLM技术架构图
International Conference on Multimedia Modeling(简称MMM)作为中国计算机学会(CCF)推荐的C类国际会议,在多媒体检索与建模方向具备深厚积淀和广泛学术影响力。会议聚焦多媒体建模、多模态内容理解、图像与视频信号处理、计算机视觉、具身智能媒体、多媒体检索评测及智能应用等前沿方向。MMM为年度会议,在全球多地轮流举办,汇聚来自世界各地高校、科研院所与头部企业的专家学者及科研团队。会议通过主会论文、创新演示、专题论坛、Video Browser Showdown竞赛等多种形式,集中展示多媒体建模与多模态智能领域的最新理论突破、技术创新与评测成果。第33届MMM 2027将于柬埔寨暹粒举办,本届会议以多媒体建模为主线,开设具身多媒体、多模态智能体等特色专题,覆盖视频理解、多媒体生成、检索评测等前沿研究方向。