MMRC实验室博士生李祥在单目视频三维人体化身重建领域的研究成果近日被《CAAI Transactions on Intelligence Technology》(CAAI TRIT)录用。
论文名称:CompAvatar: 3D Human Avatar Reconstruction from Partial-view Monocular Video by Semantic-Guided View Generation
论文作者:李祥(山东大学);孟雷(山东大学);武蕾(山东大学);李曼祎(山东大学);孟祥旭(山东大学)
Paper链接:https://doi.org/10.23919/cje.2025.00.412
论文简介:随着数字人和沉浸式交互应用持续发展,从单目视频重建高质量三维人体化身成为计算机视觉与图形学的重要研究方向。现有方法在视角覆盖不足、环境遮挡或人体自遮挡等情况下,容易因观测不完整而在未观测区域产生纹理模糊与外观失真。尽管引入预训练图像扩散模型能够补充缺失信息,但通用生成先验难以准确恢复人物特有的服饰与外观细节,并可能损害已观测区域的重建质量。针对上述问题,论文提出语义引导视图生成框架CompAvatar,通过观测建模与视图增强两个分支协同实现完整且一致的三维人体重建。观测建模分支首先依据输入视频构建初步的三维高斯人体表示;视图增强分支随后通过组件语义学习、局部视图细化和空间一致性蒸馏三个模块补全缺失外观:提取头发、服饰和鞋履等细粒度组件语义,结合视角线索训练个性化视图生成器;利用组件级异常检测定位缺陷区域,在保留已观测细节的同时进行局部修复;最后将生成视图与真实观测逐步融合至三维表示,提升跨视角一致性。论文在三个公开数据集上开展了系统实验,结果显示,相比基线方法,峰值信噪比提升1.01至1.67分贝,感知相似度误差降低约11.6%至22.7%;消融实验、定性比较与用户研究进一步验证了该框架在缺失外观恢复、人物外观一致性及视觉质量方面的有效性。
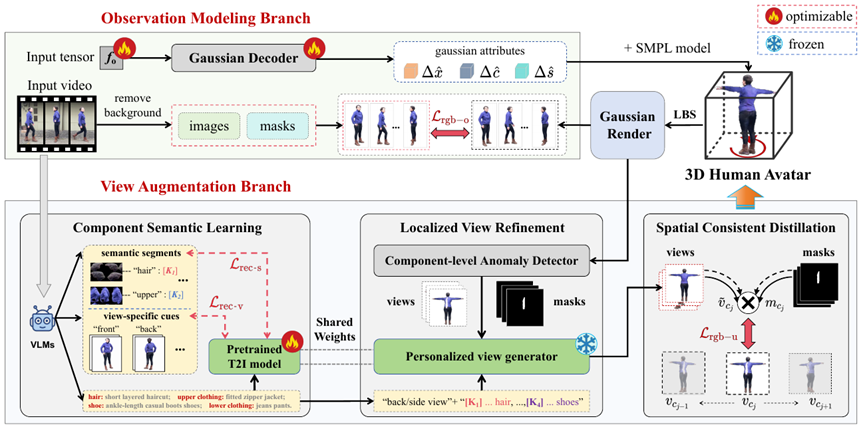
图1:CompAvatar框架图
《CAAI Transactions on Intelligence Technology》(CAAI TRIT)是中国人工智能学会旗下发表人工智能技术领域理论与实验方面原创性研究成果的重要学术平台。该刊面向人工智能前沿领域发表具有创新性和学术价值的研究成果,涵盖脑与认知、机器感知与模式识别、机器学习与计算智能、自然语言处理、机器人与群体智能、智能系统与应用等方向。该刊被SCIE、Ei Compendex、Scopus等数据库收录,并于2025年入选中科院期刊分区一区Top期刊,作为由英国工程技术学会(IET)与中国人工智能学会(CAAI)联合出版的全开放获取期刊,本刊致力于向全球读者提供可免费阅读与分享的优质研究成果。