2026年10月8日,第8届ACM亚太多媒体会议(MMAsia'26)论文录用结果公布。MMRC实验室在跨模态学习、微表情识别等方向的两项研究成果被录用。
论文名称:Diffusion-Driven Progressive Heterogeneous Feature Alignment
论文作者:李子璇(山东大学);孟雷(山东大学);吴畏(山东大学);闫晓硕(山东大学);张峰(浪潮软件科技有限公司);孟祥旭(山东大学)
Paper链接:
https://github.com/bigwahaha/RCDAlign/blob/main/Diffusive_Alignment_of_Heterogeneous_Features_for_Visual_Classification.pdf
Code链接:https://github.com/bigwahaha/RCDAlign
论文简介:跨模态对齐通过引入判别性文本语义增强视觉表示,是提升视觉分类性能的重要途径。然而,现有方法通常依赖单向映射或隐式融合等一步式对齐机制,在模态差距较大、特征分布异构的场景下难以精确建模复杂的语义关系,且对噪声和语义不一致的文本引导缺乏鲁棒性。针对这一问题,本文提出可靠性-一致性引导扩散对齐方法(RCDAlign),一种基于扩散模型的鲁棒异构视觉-语义特征对齐框架。该框架包含三个核心组件。条件特征扩散模块(CFD)通过逐步条件去噪过程,将视觉特征渐进地引导至高质量文本语义目标空间,克服了一步式对齐在大模态差距下表达能力不足的缺陷。可靠性-一致性自适应融合模块(RCAF)在每个去噪步骤中联合估计文本可靠性与视觉-文本一致性,动态抑制噪声或不一致的跨模态引导信号。置信度引导选择模块(CGS)则依据特征散度与分类置信度自适应控制融合语义特征的贡献权重,缓解困难样本中语义冲突引发的负迁移。上述设计使文本信息仅在训练阶段参与构建语义目标分布,推理时模型仅需视觉输入即可完成分类,满足实际部署中文本不可用的场景需求。在VIREO Food-172、NUS-WIDE和MSRVTT三个覆盖不同视觉-语义场景的公开数据集上,RCDAlign在八项评估指标中的七项取得最优结果,在VIREO Food-172与MSRVTT上的Top-1准确率分别超过次优方法0.84和1.13个百分点,验证了渐进式扩散对齐框架在提升视觉表示判别性方面的有效性。
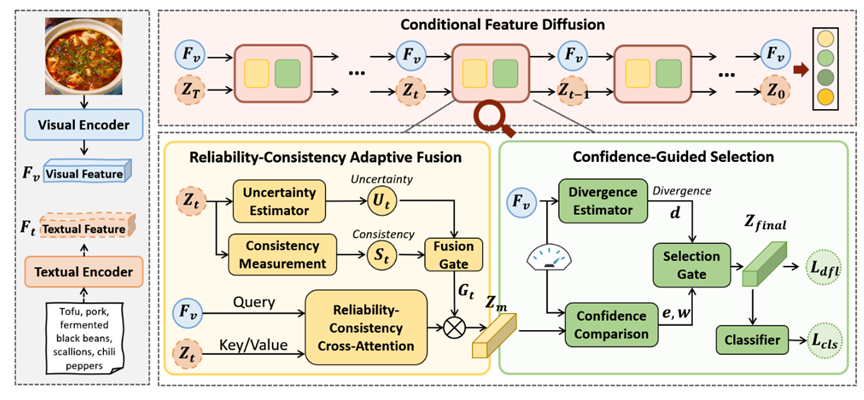
图1:可靠性-一致性引导扩散对齐技术架构图
论文名称:Facial Primitive-guided Representation Learning for Dynamic Facial Expression Recognition
论文作者:杨宗一(山东大学);孟雷(山东大学);李春波(山东大学);张亚冲(山东大学);李祥(山东大学);齐壮(山东大学);张峰(浪潮软件科技有限公司);孟祥旭(山东大学)
论文简介:动态面部表情识别旨在从真实场景视频中判断人的情绪状态,但现有方法多依赖全局时空特征,容易把表情相关的局部面部变化与背景噪声、光照变化、姿态偏移和遮挡等因素混在一起,影响模型对细粒度表情线索的捕捉。针对这一问题,本文提出面部基元引导的表征学习框架FPRL,面向纯视频动态表情识别任务,将眼睛、脸颊、鼻子和嘴巴等六类具有解剖学意义的面部基元作为局部表情先验。方法首先利用Grounded SAM 2离线生成面部基元掩码,并通过面部基元编码模块把局部区域特征转换为与ViT token同维度的基元token,从而保留更细粒度的面部证据;随后,运动时序建模模块利用相邻帧之间的基元级差分刻画局部表情运动,并引导MoAE路由,使模型更加关注与表情变化相关的动态信息;最后,基元Token注入模块通过全局到基元、基元间以及基元到全局的注意力交互,将增强后的局部线索注入全局视频表征。实验结果表明,FPRL在MAFW和DFEW数据集上相较严格纯视频S4D基线取得稳定提升,并在同类视频表情识别方法中表现出较强竞争力。消融实验和Grad-CAM可视化进一步验证了面部基元编码、运动建模和token注入对提升模型鲁棒性和可解释性的作用。
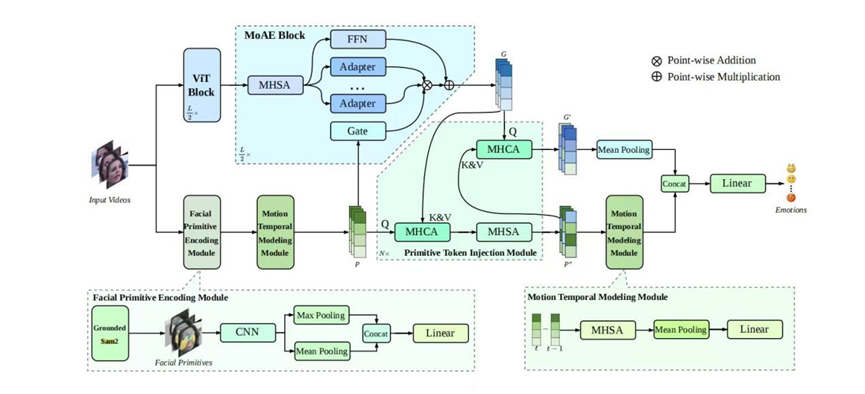
图2:面部基元引导的表征学习框架图
ACM Multimedia Asia(简称MMAsia)是国际计算机学会ACM旗下SIGMM主办的亚太地区多媒体领域顶级学术会议,作为国际顶会ACM MM的亚太区域旗舰会议,拥有极高的行业认可度与学术影响力。会议聚焦多模态人工智能、AIGC生成媒体、图像视频处理、计算机视觉、沉浸式VR/AR媒体、多媒体检索与智能应用等前沿研究方向。MMAsia每年举办一届,汇聚全球各地高校、科研机构及头部企业的专家学者与科研团队,通过主会论文、创新演示、产业论坛、青年学者论坛等多元形式,集中展示多媒体与多模态智能领域的最新理论突破、技术创新与落地成果。第8届MMAsia 2026于越南河内举办,会议主题为 “AI-Native Multimedia Systems for Emerging Digital Economies(面向新兴数字经济的原生AI多媒体系统)”,涵盖多模态分析、多媒体生成、计算机视觉等前沿方向。